4.6 Decoder-only 实战拆解:22 步走完一次前向
本页范围:第 4 章第 6 节 | 整理时间:2026-09-29
前几节介绍了多头注意力、因果掩码、归一化、前馈网络和残差连接。本节以一台真实可运行的小模型为例,从输入到输出走一遍完整前向(即顺着输入算到输出的一次计算,与训练时的反向传播相对,详见附录 A.5),列出每一步的张量形状。过程分为五步:
- 设定:拿一台真模型当解剖对象(4.6.1):以 minimind-3(64M 档小模型)的规格为解剖实例,Embedding 查表把
[10]变成[10, 768]; - 一层 Block 的毫米级走查(4.6.2):前半层自注意力十小步、后半层 FFN 四步,主干形状全程
[10, 768]不变; - 收尾:从向量到下一个词的概率(4.6.3):最终 RMSNorm、输出投影到 6400 维词表、softmax 得到概率分布;
- 参数量与计算量总账(4.6.4):63.9M 参数约七成在 FFN,一次前向约 1.3 GFLOPs,这笔账决定了第 5 章变体的靶子。
- 示例推理:一句诗的生成现场(4.6.5):训练与推理共用同一套前向;以「锄禾日当午」为例走 prefill 与 decode 两阶段,看 KV Cache 如何让每步只进 1 个 token。
读完本节,你应该能随手画出一条张量从 [10] 走到 [6400] 的形状路线图,也能说清参数和算力分别花在了哪里,还能口述一次生成请求从 prefill 到 decode 的完整过程。
图 1 标出本节走查的范围:从 Transformer 层到输出投影的完整前向过程。后续各步都按这张图确定当前位置。
这两个紫框放大之后长什么样?token ID 进去、概率分布出来,中间每一步张量是什么形状?把这条形状流水线单独画出来看:
4.6.1 设定:拿一台真模型当解剖对象
解剖对象是 minimind-3 的 64M 档:一台可实际运行的最小规格 LLM,全部数字取自其公开实现(出处见参考来源),不是举例编造。关键规格一段说清:词表 6400(模型认识的 token 总数);主干宽度 \(d=768\)(每个 token 的向量宽度);8 层 Block;注意力 8 个 Q 头配 4 组 K/V 头(GQA 分组,每头 96 维,即 768÷8,第 5 章细讲);FFN 中间宽 2432;RoPE 按最大位置 32768、基底频率 1e6 预计算;输入嵌入表与输出投影共享同一份权重。这些数字就是后面每一步形状的来源。
输入设定为序列长度 \(T=10\):假设"床前明月光,疑是地上霜"这类一句话经分词器得到 10 个 token ID,拼成形状为 [10] 的整数张量。
形状约定先说清楚:本页所有张量形状都按论文的习惯写,只保留序列长度与特征维,省略 batch 维。batch 维是「几句话一起算」的并行维度,PyTorch 实现里排在形状最前面(本例 \(B=1\)),它不参与任何一步计算,也不改变任何一步的形状规律。读者回头对照 minimind 源码时,把本页每个形状的前面补一维 batch 即可对上。
第一步是 Embedding 查表。Embedding 层本质是一张 [6400, 768] 的大表,10 个 token ID 各取一行,得到 [10, 768]。这步没有矩阵乘法,就是按编号取货。取出的 10 个 768 维向量,就是接下来所有计算的原料。
所以这步在干嘛:把离散的 token 编号翻译成连续向量,模型从此只在向量世界里做运算,整数编号本身不再参与。
另外还有一份"备料"在模型初始化时就做好了:RoPE 的余弦/正弦频率表,按最大位置 32768、头维 96 预计算,各是 [32768, 96] 的两张表。本次前向只取前 10 行,即 [10, 96],等注意力那一步再用。它是位置的函数,不含可学习参数。
4.6.2 一层 Block 的毫米级走查
一层 Block 分前后两半:前半层是自注意力,后半层是前馈网络,两半都是"先归一化、再计算、最后残差相加"的 Pre-Norm 结构。先把这层全貌画出来(图 4)——它与 4.5 节图 3 右塔、4.4 节图 4 是同一个架构;后面每个小步都是这张地图的局部放大。记住主干形状 [10, 768]。
前半层:自注意力
第 1 小步,RMSNorm。进注意力之前先做归一化:对每一个位置的 768 维向量,除以它自己的均方根,再乘一个可学习的缩放向量 \(\gamma\):
[10, 768],出 [10, 768]。符号说明:\(x\) 是某个位置的 768 维向量,\(x_i\) 是它的第 \(i\) 个分量;\(\frac{1}{d}\sum_{i=1}^{d} x_i^2\) 是全部分量平方的均值,开根号就是均方根;\(\odot\) 表示逐分量相乘,\(\gamma\) 对每个维度各给一个可学习的缩放系数。所以这步在干嘛:把每个向量调到标准尺度。不同位置的向量数值可能差好几个数量级,先拉平再投影,后面的矩阵乘法数值才稳定。
第 2 小步,Q/K/V 投影。三个不带偏置的线性层各自乘一个权重矩阵:
- Q 投影:(
[10, 768]× 权重[768, 768])→[10, 768],再按列切成 8 段得[10, 8, 96](8 个头,每头 96 维); - K 投影:(
[10, 768]× 权重[768, 384])→[10, 384],切成 4 段得[10, 4, 96]; - V 投影:(
[10, 768]× 权重[768, 384])→[10, 384],切成 4 段得[10, 4, 96]。
768 拆成 8×96,384 拆成 4×96:Q 有 8 个头,K 和 V 只有 4 个头。这就是 GQA(分组查询注意力),每 2 个 Q 头共享同一组 K/V。注意按头拆分只改"看待数据的方式",不复制、不计算,96×8 还是那 768 个数。
GQA 省的是 K/V 的参数量与推理时的 KV Cache 显存,动机与变体(MQA、MLA)留给第 5 章。本节的形状事实是:Q 8 头、K/V 4 头,每个头 96 维。
所以这步在干嘛:同一句话被打包成 8 份不同的"问法"(Q)和 4 组"标签加内容"(K/V),每个头从自己的视角去理解这句话。
第 3 小步,QK-Norm 与 RoPE 旋转。minimind 先对每个头的 Q、K 各做一次 96 维 RMSNorm(一个稳定注意力的小技巧),再把第 4.6.1 节备好的 [10, 96] 余弦/正弦表广播成 [10, 1, 96],按 RoPE 的旋转规则旋进 Q 和 K。两小步都不改形状:Q 仍 [10, 8, 96],K 仍 [10, 4, 96]。RoPE 的原理(为什么旋转等于注入位置)在第 3.4 节已经讲透,这里只认形状。
所以这步在干嘛:给每个头里的向量按位置编号"拧一个角度"。同一个词出现在第 2 个位置和第 9 个位置,旋转后的向量就不一样了,模型由此感知先后顺序。
第 4 小步,对齐头数。打分前把 K/V 的 4 个头复制成 8 个(每组各复制 2 份),再把三个张量的"头"维都挪到第 2 维:Q/K/V 统一成 [8, 10, 96]。挪维度是为了下一步能对每个头单独做矩阵乘法。
第 5 小步,计算注意力分数。每个头内部,Q 乘 K 的转置,再除以 \(\sqrt{d_k}\):
[8, 10, 96] @ [8, 96, 10] 得到分数 [8, 10, 10]:每个头一张 10×10 的"亲密度表",第 \(i\) 行第 \(j\) 列表示位置 \(i\) 对位置 \(j\) 的关注程度(归一化之前)。符号说明:\(Q,K,V\) 是第 2–4 小步备好的查询、键、值张量,均已按头重排为 [8, 10, 96];\(K^{\top}\) 表示交换 \(K\) 的最后两维;softmax 在最后一维上做,把每行分数归一化成和为 1 的权重;乘 \(V\) 即按权重加权求和。 第 6 小步,加因果掩码。给分数加上一个上三角(不含主对角线)全为 \(-\infty\) 的 10×10 矩阵,形状不变,仍是 [8, 10, 10]。
易错点:因果掩码是自回归模型的硬约束:位置 \(i\) 只允许看第 1 到第 \(i\) 个位置。被填 \(-\infty\) 的格子经 softmax 后权重精确等于 0,未来信息被物理封死,不存在"稍微看一点"的中间态。训练与推理都受这条约束。
所以这步在干嘛:第 5、6 小步合起来,是让每个位置算清楚"在我之前的这些位置里,我该听谁的话",并且不许偷看答案。
第 7 小步,softmax。对 [8, 10, 10] 的最后一维做 softmax,每行变成一组和为 1 的权重。分数从此有了概率的含义:位置 \(i\) 该把百分之几的注意力分给位置 \(j\)。
第 8 小步,加权求和 V。权重矩阵乘 V:[8, 10, 10] @ [8, 10, 96] → [8, 10, 96]。位置 \(i\) 的新向量,是所有(允许的)位置的 V 按权重调和出来的混合体。
所以这步在干嘛:第 7、8 小步是"按票数收内容":先决定听谁的话各占几成,再按比例把各位置的内容调和成每个位置的新向量。
第 9 小步,拼头与输出投影。拼接是第 2 小步"按列切段"的逆操作:头 1 的 96 维放回第 1–96 列,头 2 的放回第 97–192 列,依序各回各位,恢复原状 [10, 768]。拼接只把 8 份结果放到不同列区间,还没有在头之间交换信息。紧接着的输出投影乘上 [768, 768] 的 W_O,输出的每一维都是全部 768 个输入维度的加权和,因此会混合 8 个头的信息,输出仍是 [10, 768]。
举个例子。句子「那只猫追蝴蝶,因为它饿了」读到「它」时:头 1 可能专攻指代,把「猫」的内容拉了进来;头 3 专攻因果,拉进来的是「饿」;头 5 盯着动作,拉进来的是「追」。拼接之后,「它」的 768 维向量里,第 1 段装着"我是猫"、第 3 段装着"我饿了"、第 5 段装着"我在追",互不干扰。过 W_O 之后,这些线索被混合成一个整体——下一层看到的「它」,不再是词典里那个孤零零的代词,而是"那只饿着肚子追蝴蝶的猫"。至于每个头的发现该听几成,W_O 的权重全是训练里学出来的:对下游任务有用的头,权重自然越调越大。
所以这步在干嘛:拼接只是"各回各位",W_O 才是"开会汇总"。从这一刻起,8 个头分头打听到的东西汇成一股,交给残差加法,流向这一层的后半层。
第 10 小步,残差相加。注意力的输出与这一半层的输入直接相加:两个 [10, 768] 逐元素加,结果还是 [10, 768]。
所以这步在干嘛:新信息叠加在原向量上,原始信息一点不少。深层网络堆几十上百层还能训练得动,残差连接居首功(第 4.4 节)。
工程实现里,第 5 到 8 小步通常由一个融合算子(FlashAttention 类)一步算完,数学结果与分步计算完全等价,只是不把 [8, 10, 10] 的完整分数矩阵显式存下来。本文拆开来走,是为了让你看清里面发生了什么。
后半层:前馈网络
第 11 小步,第二次 RMSNorm。与第 1 小步同法、不同参数:换一组缩放向量 \(\gamma\),把每个位置的 768 维向量再归一化一遍(post_attention_layernorm),形状不变 [10, 768]。Pre-Norm 的规矩是"进任何子层之前先归一化",FFN 也不例外。
第 12 小步,gate / up 双路投影。同一份输入同时乘两个权重矩阵,都升到 2432 维:
- gate 投影:(
[10, 768]× 权重[768, 2432])→[10, 2432],这一路要过 SiLU 当闸门; - up 投影:(
[10, 768]× 权重[768, 2432])→[10, 2432],这一路原样保留内容。
第 13 小步,SiLU 门控相乘。gate 路先过 SiLU 激活,再与 up 路逐元素相乘(\(\odot\),不是矩阵乘法):两路 [10, 2432] → [10, 2432]。gate 路的每个数值相当于一个"开度",决定 up 路对应位置的数值放行多少——这就是"门控"的物理含义。
第 14 小步,down 投影压回。([10, 2432] × 权重 [2432, 768])→ [10, 768],回到主干宽度。
[10, 768]。符号说明:\(\mathrm{gate},\mathrm{up},\mathrm{down}\) 分别是门控、上路、降维三个线性投影,权重形状(乘法方向:输入维 × 输出维)依次是 [768, 2432]、[768, 2432]、[2432, 768];\(\odot\) 是逐元素相乘,SiLU 处理过的 gate 路调节 up 路每个数值放行多少。 第 15 小步,残差相加。FFN 的输出与后半层的输入(第 11 小步之前的那份 [10, 768])逐元素相加,与第 10 小步同理。一层 Block 到此结束:进 [10, 768],出 [10, 768]。
所以这步在干嘛:把每个位置的向量升到 2432 维"展开加工",用门控筛掉没用的成分,再压回 768 维。注意每个位置是独立过 FFN 的,位置之间互不交流;跨位置的信息交换只发生在注意力那半层。
同样的 Block 一共堆 8 层,结构完全相同、参数各自独立。从第 2 层到第 8 层,主干形状始终是 [10, 768],一层层改变的只有数值——每层都在上一层的理解之上再加工一轮。
4.6.3 收尾:从向量到下一个词的概率
8 层全部走完后,还有三小步:
- 最终 RMSNorm(
self.norm):[10, 768]→[10, 768],收尾再稳一次数值; - 输出投影:乘共享嵌入表
[6400, 768]的转置,即([10, 768]×[768, 6400])→[10, 6400]。每个位置得到 6400 个分数,对应词表里每个 token 的"得票"; - 取最后位置 + softmax:预测下一个词只需要最后一个位置的分数
[6400],softmax 后得到 6400 个和为 1 的概率,即模型对"下一个 token 是谁"的回答。
所以这步在干嘛:为什么只取最后一行?因为每个位置的输出,含义都是"基于我左边看到的所有词,猜下一个词"——而只有最后一个位置看完了整句话:
- 位置 1 的行 = 只看过「我」→ 预测第 2 个词;
- 位置 2 的行 = 看过「我、爱」→ 预测第 3 个词;
- ……(中间各行同理,能看多长就预测到多远的下一个);
- 位置 10 的行 = 看完全部 10 个词 → 预测第 11 个词,这是唯一真正未知的。
前 9 个位置预测的"下一个词"本来就在输入里(就是第 2–10 个词本身),没有新信息,所以推理时只取最后一行:[10, 6400] → [6400]。前 9 行也并非白算:训练时每个位置的答案都已知,10 行全部拿去对答案、算损失,一次前向相当于做了 10 道预测题,这正是训练高效的原因(推理时的省法则由第 12、13 章的 KV Cache 等机制接手)。第 11 个词生成后接回句尾,整个流程重跑一遍、再取新的最后一行预测第 12 个词——这就是第 0 章说的自回归循环,"取最后位置"是这个循环每一步的出口。
输出投影与 Embedding 共享同一张 [6400, 768] 的权重表:进模型时按行查表,出模型时用同一张表做投影,省了近 500 万参数。原论文第 3.4 节同样让输入/输出嵌入与 softmax 前的线性变换共享权重,是沿用至今的经典做法。另外,预测下一个词只需要最后一个位置的分数,实际生成时不必为全部 10 个位置都做这次词表宽度的投影。
输出投影给出的 6400 个数还不是概率,可正可负、大小不限,叫 logits。softmax 把它们压缩到 0 到 1 之间且总和为 1,才成为概率分布。采样、贪心、温度调节等解码策略(第 12 章)都是在 logits 或它对应的概率上做文章。
所以这步在干嘛:把 768 维的"理解结果"翻译回词表世界:6400 个候选 token 各得一个概率,概率最高(或被采样中)的那个接在序列末尾,整个流程再重复一遍——这就是自回归生成的最小循环。
全程的形状变化只有三种:主干恒为 \([T, 768]\);注意力内部按头重排(768 ↔ 8×96);FFN 内部升维(768 → 2432 → 768)。最后一次性投影到 6400 维词表。抓住"主干不变"这条纲,再深的网络走查起来也不会迷路。
走查完毕,把 22 步钉在同一张图上收账(图 9)。它与 4.6.2–4.6.3 的逐小步讲解是同一条流水线:右两列给出每步的输入与输出形状,卡在哪一步就回哪一节复查:
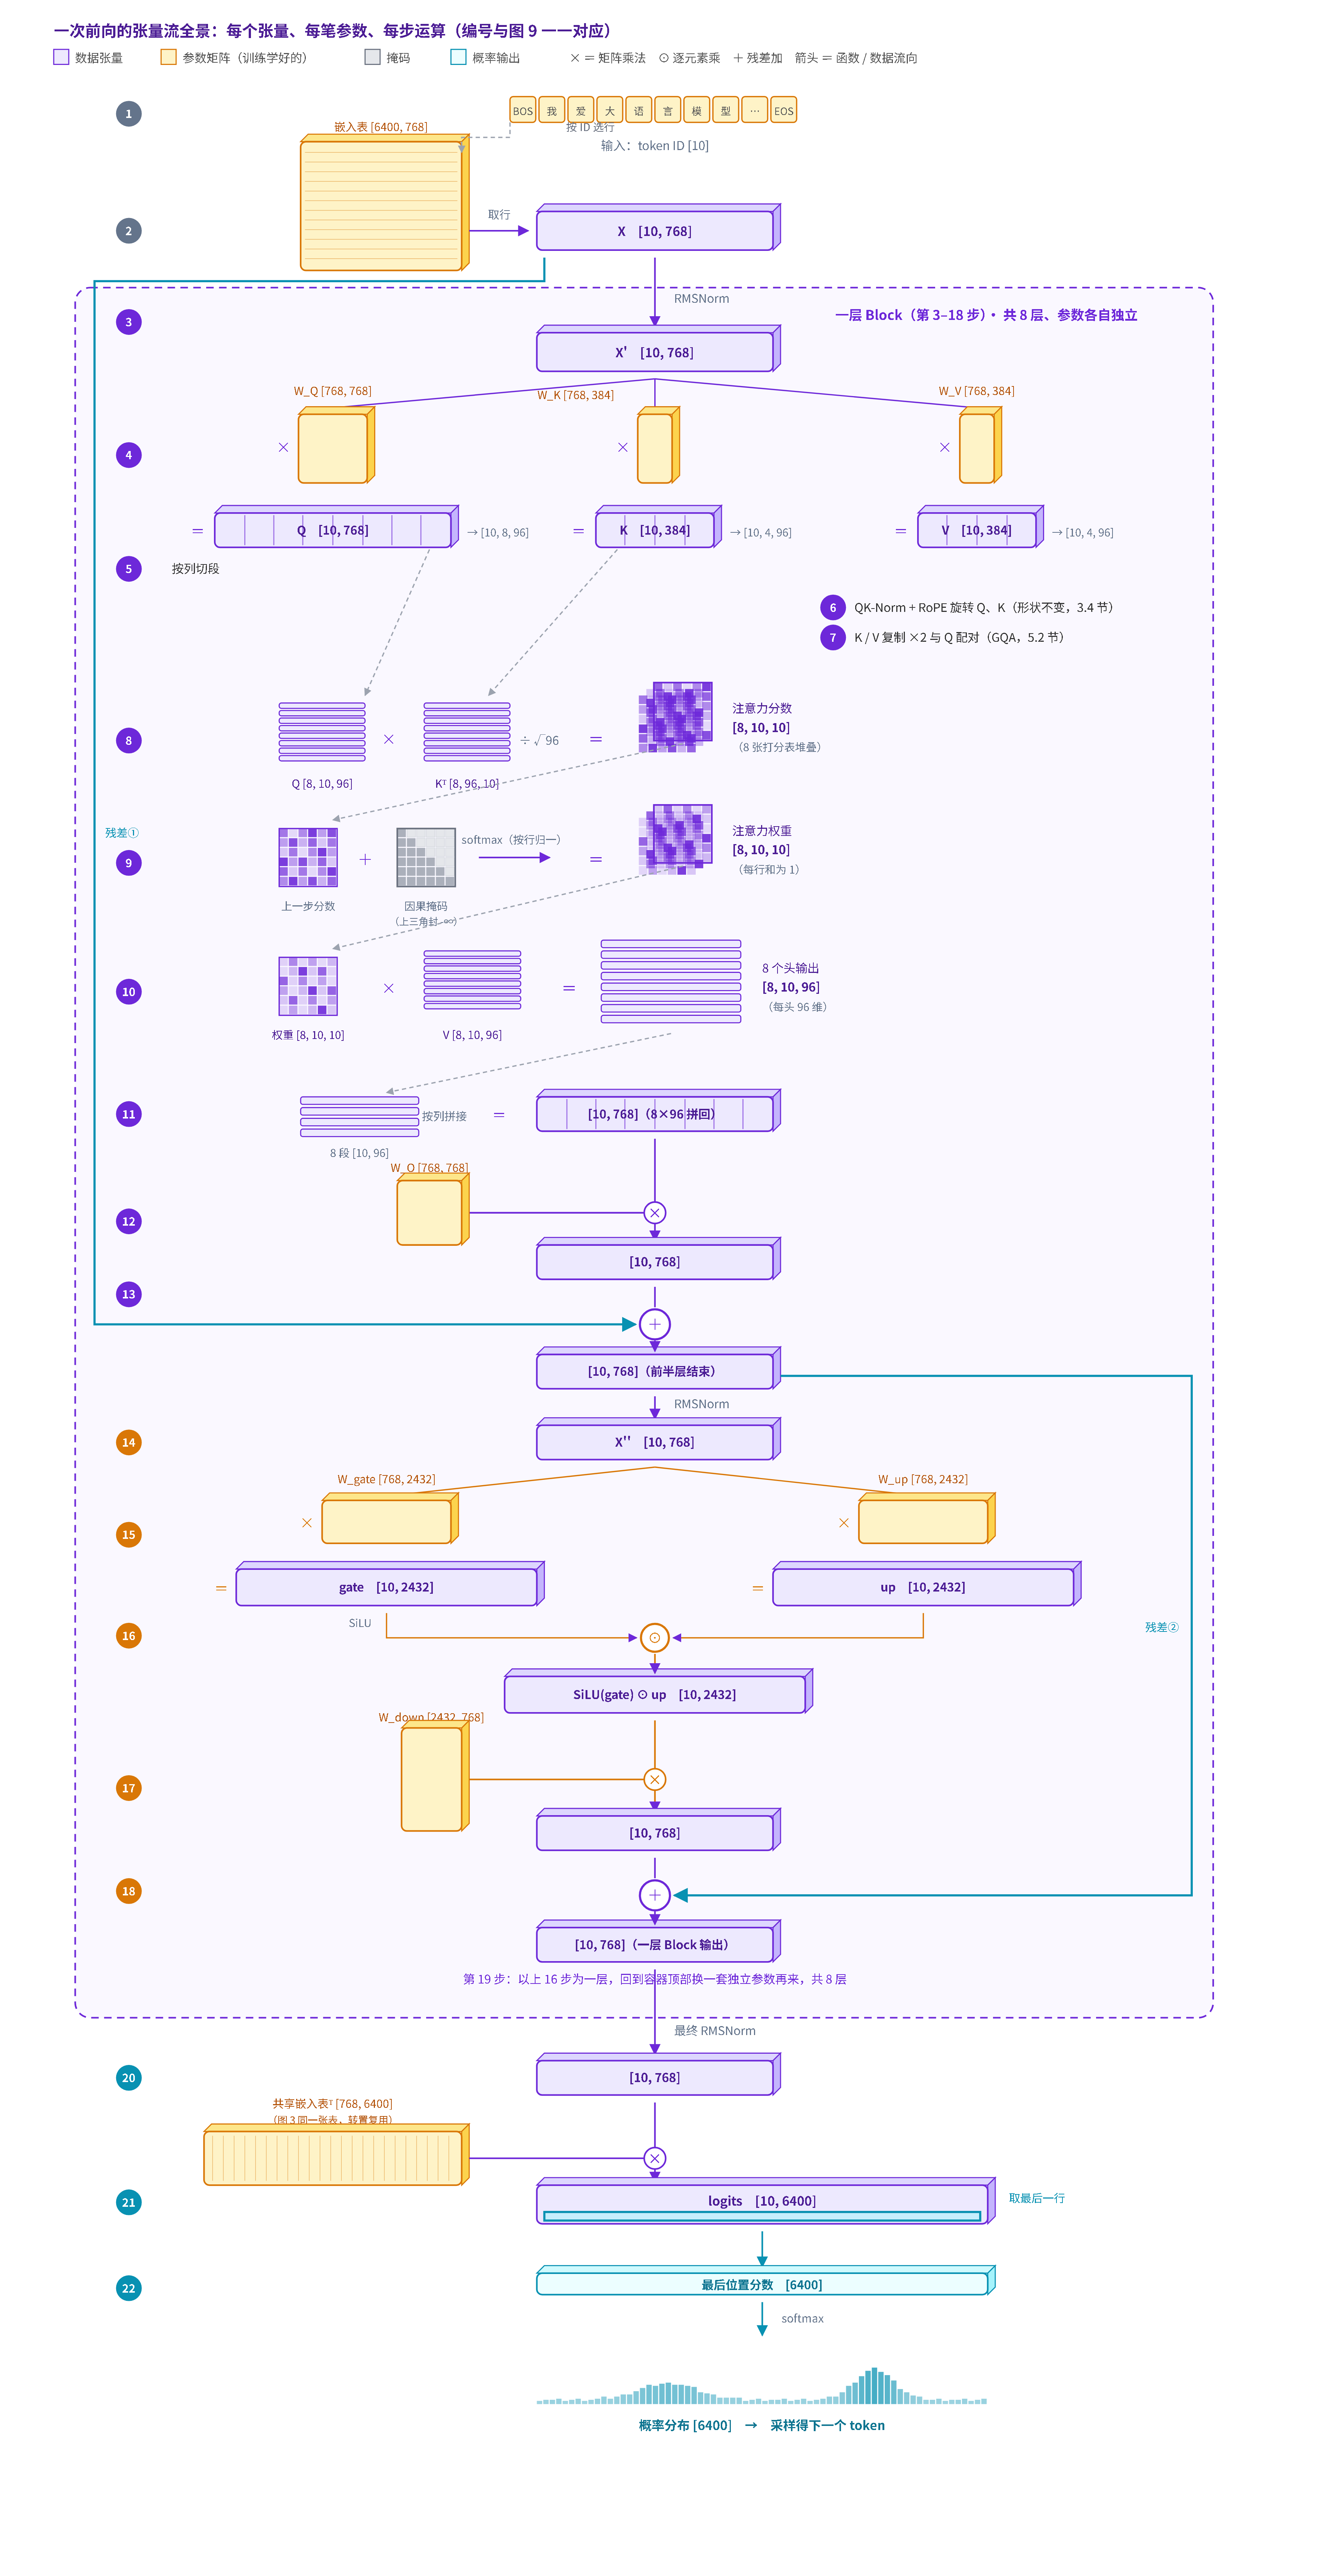
图 9 是文字账,同一笔账再画成张量流全景(图 10):每个张量画成带形状的块,每笔参数画成橙色矩阵,矩阵乘、逐元素乘、残差加逐步排开,编号与图 9 一一对应。自上而下读一遍,就是这台小模型把 10 个 token 变成下一个词的概率的完整过程:
4.6.4 参数量与计算量总账
形状清楚了,再算两笔账:参数存在哪,算力花在哪。参数量按 4.6.1 节的真实配置逐模块算(所有线性层都无偏置):
| 部件 | 计算式 | 参数量 | 占比 |
|---|---|---|---|
| Embedding 表(与输出投影共享) | \(6400 \times 768\) | 4,915,200 | 7.7% |
| 注意力投影 ×8 层 | \(8 \times (768^2 + 2 \times 768 \times 384 + 768^2 + 2 \times 96)\) | 14,157,312 | 22.2% |
| FFN 三个矩阵 ×8 层 | \(8 \times 3 \times 768 \times 2432\) | 44,826,624 | 70.1% |
| 全部 RMSNorm | \(8 \times 2 \times 768 + 768\) | 13,056 | 0.02% |
| 合计 | 63,912,192 ≈ 63.9M | 100% |
63.9M 就是"64M 档"这个名字的由来。单层看,注意力约 1.77M(Q/K/V/O 四个投影外加 QK-Norm 的 192 个参数),FFN 约 5.60M,FFN 是注意力的三倍多。这份分布不是偶然,而是现代 LLM 的普遍形态:模型的参数大头在 FFN 里,它常被看作模型存储"知识"的主要场所。
参数量分布:FFN 约 70%,注意力约 22%,Embedding 约 8%,归一化不到万分之一。第 5 章的 MoE(混合专家)改造的正是占大头的 FFN,KV Cache 优化瞄准的则是注意力——看懂这笔账,第 5 章每个变体的动机就都不言自明。
计算量用一条经典经验式估算(Kaplan 等人 2020 年归纳):前向一次的浮点运算量约等于 \(2 \times\) 参数量 \(\times\) token 数,系数 2 对应每个参数在一次矩阵乘里的一次乘加:
两点提醒。第一,这条经验式忽略了注意力分数那一步(\(2 h T^2 d_k\) 次运算):本例 \(T=10\),它只占约 0.1%,可以忽略;但它随 \(T\) 平方增长,序列一长就不可忽略,这是第 7 章(训练算力)和第 13 章(长序列推理、KV Cache)要正面处理的问题。第二,1.3 GFLOPs 听起来大,一块普通 GPU 每秒能算几十 TFLOPs,这台 64M 小模型前向一次只是眨眼功夫;真正的成本在训练时要对万亿 token 反复前向加反向,那是第 6、7 章的主题。
至此,从 [10] 的整数编号到 [6400] 的概率分布,每一步的形状、每一类参数的去向、每一份算力的花销都摆在了台面上。第 5 章将看到,RMSNorm、SwiGLU、GQA 这些"现代变体"为什么能全面取代原论文的初代设计——你已经有了评判它们的全部基础。
4.6.5 示例推理:一句诗的生成现场
读到这里,有一笔糊涂账要先算清:本节走查的到底是训练还是推理?答案是两者共用的前向传播。训练 = 前向 + 算损失 + 反向传播 + 更新参数,循环几百万次;推理 = 前向 + 取最后一行采样 + 把新词接回句尾再前向,逐词循环。中间"token ID → 8 层 Block → 6400 分"这段数学与形状,两边一模一样。前四刀拆的是共用主干,这一刀把推理侧补全:拿一个具体请求,看生成是怎么一字一字发生的。
用户提问:「锄禾日当午这句诗的下一句是什么。」
第 0 步,包装与分词。对话模型先把问题套进训练时约定的对话模板(ChatML 风格):
<|im_start|>user\n锄禾日当午这句诗的下一句是什么。<|im_end|>\n<|im_start|>assistant\n分词器把整串切成 token ID,假设共 25 个。这串 ID 就是模型的全部输入——模型看到的不是"问题",只是 25 个整数。
第 1 步,prefill:整段一次算完。25 个 token 一起走 4.6.1–4.6.3 那遍流程:Embedding 成 [25, 768],过 8 层 Block(因果掩码生效),塔顶投影成 [25, 6400],只取最后一行(位置 25 看完了整个问题),softmax 后采样出第一个输出 token「汗」。同时每一层把 25 个位置的 K/V 存进 KV Cache,后面不再重算。注意 8 层是 8 套各自独立的参数:每层约 177 万注意力参数加 560 万 FFN 参数(4.6.4 的账),层与层互不共享;而 25 个 token 在同一层里共用该层同一套权重——参数按层分、不按 token 分,输入 25 个词还是 2500 个词,参数一个不多一个不少。
第 2 步,decode:每步只进一个新 token。生成「汗」之后,序列逻辑上变成 26 个 token,但绝不需要把 26 个全部重送。因果掩码决定:位置 \(i\) 的输出只看 \(1..i\),第 26 个词来了,前 25 个位置在每一层的向量都纹丝不动——既然不变,重算就是白算。于是只把「汗」送进去:
[1] → Embedding [1, 768] → 每层:过自己的 W_Q / W_K / W_V 得 q、k、v(模具同一套,1 行进)
    → k、v 追加进缓存(每层缓存变 [26, 96] × 4 组)
    → q 与缓存里 26 个 K 打分 [8, 1, 26] → softmax → 乘 26 个 V → 每头 [1, 96]
→ 塔顶投影 [1, 6400] → 取这唯一一行 → 采样「滴」
打分矩阵从 prefill 的 [8, 25, 25] 缩成 [8, 1, 26]:新位置只有一行要打,26 个键值里 25 个来自缓存。这与"26 个 token 全部重算"的数学结果完全相等,缓存删掉的只是注定不变的重算。循环往复:「禾」「下」「土」「。」逐个吐出。
第 3 步,停止与解码。「。」之后再跑一步,EOS(结束符)概率最大,命中停止条件,循环结束。生成的 token ID 交给分词器反向解码回文字,用户看到回答:「汗滴禾下土。」回答多长从不预设——每步只决定下一个词,停不停由 EOS 的概率说了算(采样策略与停止条件是第 12 章的主题)。
总账:这次请求共 1 次 prefill(25 个 token)加 6 次 decode(每次 1 个),合计 7 次前向。模型并没有把整句诗背出来再写——每个字都是看完已有全部内容后现场投出的一票,能答对是因为这类诗句的接续模式在训练时被压进了参数。
模具与零件,最后再钉一次:W_Q、W_K、W_V 是训练学好的模具(参数,冻结不变);Q、K、V 是用模具现场压出的零件(数据,随输入重算)。prefill 一次压 25 套,decode 一次压 1 套,模具始终是同一套。整个生成过程,就是同一套模具在自回归循环里被反复使用。
[T, 768]。[6400, 768] 权重表,原论文 3.4 节也用了同样的共享做法。参考来源
- Vaswani et al., 2017. Attention Is All You Need(arXiv:1706.03762):本文公式 (2) 与该文公式 (1) 逐字核对一致,嵌入/输出权重共享出自其 3.4 节,对照 ref_paper 中文译稿核实。本页正文所称「原论文」即此篇。
- minimind 工程(jingyaogong/minimind,Apache 2.0):本页全部规格数字、参数拆解与张量形状以其 minimind-3(64M 档)实现及官方规格表为准(词表 6400、8 层、768 维、8 个 Q 头、4 组 KV 头、FFN 中间宽 2432)。正文只讲算法与形状,代码细节不在页面内引用。注意代码里的张量形状比本页多一维 batch(本例 B=1),对照时把本页每个形状前面补上这一维即可。
- Kaplan et al., 2020. Scaling Laws for Neural Language Models(arXiv:2001.08361):前向计算量 \(C \approx 2NT\) 的经验估算出自该文表 1,本文公式 (4) 另用逐模块手算交叉验证。
- Zhang & Sennrich, 2019. Root Mean Square Layer Normalization(arXiv:1910.07467):公式 (1) RMSNorm 的出处,实现细节以 minimind 源码为准。
- 4.6.5 的推理流程(对话模板、prefill / decode、KV Cache、EOS 停止)为本手册对前文的综合演绎,系统性展开见第 12 章(解码策略与停止条件)与第 13 章(KV Cache 与推理系统)。
- Su et al., 2021. RoFormer: Enhanced Transformer with Rotary Position Embedding(arXiv:2104.09864):RoPE 原始论文,旋转原理详见本手册 3.4 节。